[Ảnh đại diện (thumbnail 1200×675) 0] Thay khối này bằng block Ảnh.
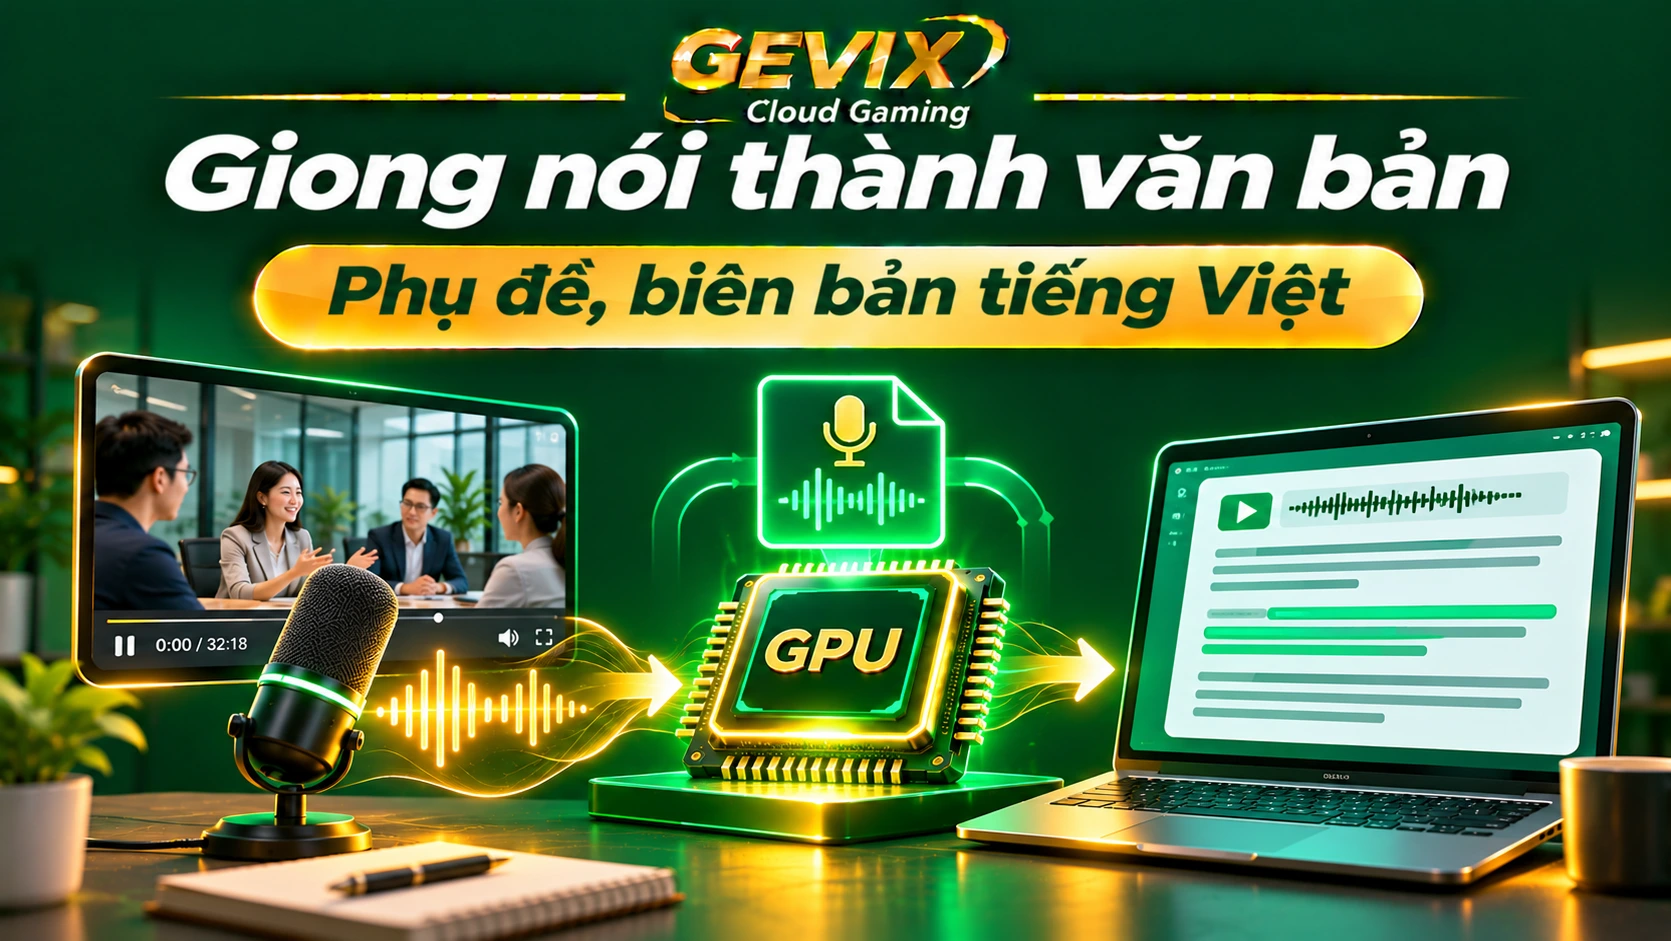
Prompt: Meeting room recording turning into text, sound waves flowing from a microphone and a video frame into a glowing GPU chip, then becoming neat lines of subtitle text on a laptop screen, emerald green and warm gold lighting, cinematic corporate digital art. Blog thumbnail layout, everything centered horizontally, the scene occupies the lower 60% of the frame and the top fades into a dark emerald (#03301D) vignette so the text is legible. Top center: the GEVIX brand lockup: the word “GEVIX” in heavy bold italic sans-serif with a shiny metallic gold gradient (#F6DC86 to #E2B444 to #B5841F) and a thin glowing gold swoosh arc curving around its right side, with the words “Cloud Gaming” in smaller bold italic white letters directly beneath, aligned to the right half of “GEVIX”; thin gold horizontal hairlines extend from both sides of the lockup toward the edges. Below the lockup, a very large headline in white, exact Vietnamese text: “Giọng nói thành văn bản”, with a subtle soft shadow. Directly under the headline, a wide rounded glossy gold gradient pill with a soft glow, containing exact text in bold dark emerald (#03301D): “Phụ đề, biên bản tiếng Việt”. Typography: heavy bold modern sans-serif (Be Vietnam Pro style) that renders Vietnamese diacritics correctly; brand palette: deep emerald green #03301D / #0A7A45, neon green glow #2BD46A accents and metallic gold #E2B444. Spell every word exactly as given; no other text, no third-party logos, no watermark. 16:9, 1200×675.
Alt: Sóng âm từ ghi âm cuộc họp được GPU chuyển thành dòng văn bản và phụ đề
Tóm tắt: Doanh nghiệp có thể tự chuyển ghi âm cuộc họp, phỏng vấn, video thành văn bản tiếng Việt bằng Whisper của OpenAI hoặc PhoWhisper do VinAI tinh chỉnh cho tiếng Việt, cả hai đều mã nguồn mở dùng thương mại được. Chạy bằng faster-whisper, mô hình lớn nhất chỉ cần khoảng 6GB VRAM; một card RTX 4060 xử lý nhanh gấp 4–6 lần thời gian thực. Dữ liệu ghi âm ở lại trên máy của bạn.
Doanh nghiệp dùng speech to text vào đâu?
- Biên bản họp: gỡ băng cuộc họp, hội thảo, rồi tóm tắt bằng mô hình ngôn ngữ chạy nội bộ (xem bài chạy LLM cục bộ).
- Phụ đề video: agency, kênh đào tạo, kênh YouTube làm phụ đề tiếng Việt tự động rồi chỉ sửa lại.
- Báo chí, nghiên cứu: gỡ băng phỏng vấn dài hàng giờ.
- Tổng đài: chuyển cuộc gọi thành văn bản để kiểm tra chất lượng, tìm từ khóa khiếu nại.
- Lồng tiếng, dịch video: bước đầu là có bản chép lời, sau đó dịch và đọc lại bằng giọng đọc AI.
Chọn mô hình cho tiếng Việt
| Mô hình | Kích thước | Giấy phép | Ghi chú |
|---|---|---|---|
| PhoWhisper-large | 1,55 tỉ tham số | Apache-2.0 (GitHub) | VinAI tinh chỉnh trên 844 giờ tiếng Việt nhiều vùng miền |
| PhoWhisper-medium, small | 769M, 244M | Apache-2.0 (GitHub) | Nhẹ hơn, sai số cao hơn một chút |
| Whisper large-v3 | 1,5 tỉ | MIT | Đa ngôn ngữ, gốc của các bản tinh chỉnh |
| Whisper large-v3-turbo | Giảm decoder từ 32 xuống 4 lớp | MIT | Nhanh hơn khoảng 8 lần, độ chính xác gần bằng |
| EraX-WoW-Turbo V1.1 | Dựa trên large-v3-turbo | MIT | Tinh chỉnh tiếng Việt 8 vùng miền và 10 ngôn ngữ khác |
PhoWhisper được tinh chỉnh từ Whisper trên bộ dữ liệu 844 giờ gồm nhiều giọng vùng miền (VinAI — GitHub). Trên bộ kiểm thử VIVOS, bản large đạt tỉ lệ lỗi từ 4,67%, bản small 6,33%. Lưu ý: trang mô hình trên Hugging Face ghi BSD-3-Clause còn kho GitHub ghi Apache-2.0; cả hai đều cho phép dùng thương mại.
Whisper large-v3-turbo cắt số lớp decoder từ 32 xuống 4, nhanh hơn khoảng 8 lần mà độ chính xác gần như tương đương với các ngôn ngữ phổ biến; với ngôn ngữ ít dữ liệu thì nên thử cả hai (GigaGPU). EraX-WoW-Turbo là bản turbo tinh chỉnh tiếng Việt của nhóm EraX, giấy phép MIT, nhóm công bố tỉ lệ lỗi sơ bộ khoảng 12% và đang hoàn thiện kết quả đánh giá (Hugging Face).
Cách chọn thực tế: lấy 10–15 phút ghi âm thật của doanh nghiệp (giọng nhân viên, tiếng ồn phòng họp, thuật ngữ ngành), chạy thử 2–3 mô hình và đếm lỗi. Kết quả trên ghi âm của bạn quan trọng hơn điểm benchmark.
[Ảnh minh họa 1] Thay khối này bằng block Ảnh.
Prompt: Comparison illustration of three AI speech models as glowing cards, each turning a Vietnamese audio waveform into text lines with a small accuracy gauge and a speed gauge, emerald green and gold on dark background, flat modern infographic. Add a short caption, exact Vietnamese text: “So sánh mô hình tiếng Việt” in bold white letters on a rounded dark emerald (#03301D) label with a thin gold border at the top-left. Bottom-right corner, small: the GEVIX brand lockup: the word “GEVIX” in heavy bold italic sans-serif with a shiny metallic gold gradient (#F6DC86 to #E2B444 to #B5841F) and a thin glowing gold swoosh arc curving around its right side, with the words “Cloud Gaming” in smaller bold italic white letters directly beneath, aligned to the right half of “GEVIX”. Typography: heavy bold modern sans-serif (Be Vietnam Pro style) that renders Vietnamese diacritics correctly; brand palette: deep emerald green #03301D / #0A7A45, neon green glow #2BD46A accents and metallic gold #E2B444. Spell the text exactly as given; no other text, no third-party logos. 16:9, 1200×675.
Alt: So sánh các mô hình chuyển giọng nói thành văn bản tiếng Việt
Cần GPU thế nào?
Whisper nhẹ hơn nhiều so với mô hình tạo ảnh hay LLM. Chạy bằng faster-whisper (dùng CTranslate2), large-v3 cần khoảng 6GB VRAM ở FP16 so với khoảng 10GB của bản PyTorch gốc, và khoảng 4GB ở INT8; tốc độ trên GPU nhanh hơn bản gốc 2–4 lần với độ chính xác như nhau (VexaScribe).
| GPU | Tốc độ large-v3 (ước tính) | 1 giờ ghi âm xử lý trong |
|---|---|---|
| RTX 3060 12GB | 3–4 lần thời gian thực | 15–20 phút |
| RTX 4060 8GB | 4–6 lần | 10–15 phút |
| RTX 4060 Ti 16GB | 5–7 lần | 9–12 phút |
| RTX 4090 24GB | khoảng 12 lần (FP16) | khoảng 5 phút |
Số liệu từ bài so sánh GPU cho Whisper năm 2026 (dev.to). Bản turbo nhanh hơn nhiều so với bảng này. Với file dài, nên cắt thành đoạn khoảng 30 giây để GPU chạy đều và đỡ tốn VRAM.
Kết luận cho doanh nghiệp: không cần thuê card lớn. RTX 3060 hoặc 4060 đủ cho phần lớn nhu cầu; chỉ khi có kho lưu trữ hàng nghìn giờ cần xử lý gấp mới cần RTX 4090 hoặc nhiều máy cùng lúc.
Quy trình gỡ băng hàng loạt
- Gom file: đưa ghi âm, video lên ổ dữ liệu của máy thuê. Âm thanh nhẹ hơn video nhiều, nên tách tiếng ra file WAV hoặc MP3 trước khi tải lên.
- Chạy hàng loạt: script faster-whisper xử lý cả thư mục, xuất file văn bản và phụ đề SRT kèm mốc thời gian.
- Tách người nói (nếu cần): thêm bước nhận diện người nói để biên bản ghi rõ ai nói câu nào.
- Sửa và tóm tắt: người phụ trách sửa tên riêng, thuật ngữ; nếu cần, dùng LLM nội bộ để tóm tắt biên bản.
- Xóa dữ liệu: xóa file gốc trên máy thuê khi xong việc.
Ví dụ lệnh cài và chạy thử:
pip install faster-whisper
python -c "from faster_whisper import WhisperModel; m = WhisperModel('large-v3', device='cuda', compute_type='float16'); segs, info = m.transcribe('hop.mp3', language='vi'); print('\n'.join(s.text for s in segs))"
[Ảnh minh họa 2] Thay khối này bằng block Ảnh.
Prompt: Pipeline illustration from left to right: a folder of meeting recordings, a GPU server processing a queue of audio files, output subtitle files with timestamps, and a summarized meeting minutes document, emerald green and gold on dark background, flat modern style. Add a short caption, exact Vietnamese text: “Ghi âm → phụ đề → biên bản” in bold white letters on a rounded dark emerald (#03301D) label with a thin gold border at the top-left. Bottom-right corner, small: the GEVIX brand lockup: the word “GEVIX” in heavy bold italic sans-serif with a shiny metallic gold gradient (#F6DC86 to #E2B444 to #B5841F) and a thin glowing gold swoosh arc curving around its right side, with the words “Cloud Gaming” in smaller bold italic white letters directly beneath, aligned to the right half of “GEVIX”. Typography: heavy bold modern sans-serif (Be Vietnam Pro style) that renders Vietnamese diacritics correctly; brand palette: deep emerald green #03301D / #0A7A45, neon green glow #2BD46A accents and metallic gold #E2B444. Spell the text exactly as given; no other text, no third-party logos. 16:9, 1200×675.
Alt: Quy trình gỡ băng hàng loạt từ ghi âm đến phụ đề và biên bản
Ghi âm là dữ liệu cá nhân
Giọng nói và nội dung cuộc họp có thể chứa dữ liệu cá nhân. Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ 01/01/2026 (Báo Lào Cai). Thông báo cho người tham gia trước khi ghi âm, chỉ dùng bản chép lời đúng mục đích, và chọn nơi xử lý mà bạn kiểm soát được. Chạy mô hình trên GPU riêng thay vì gửi file cho dịch vụ bên ngoài là một cách để giữ dữ liệu trong tầm kiểm soát.
| GPU | VRAM | Giá theo giờ | Phù hợp | |
|---|---|---|---|---|
| RTX 3090 | 24GB | 12.000đ | Tạo ảnh Flux, video AI, LoRA | Dùng thử |
Giá tính theo giờ sử dụng thực tế, chưa gồm VAT nếu có. Cập nhật: 14/11/2026.
Câu hỏi thường gặp
Mô hình chuyển giọng nói thành văn bản tiếng Việt nào chính xác nhất?
PhoWhisper-large của VinAI là lựa chọn mạnh cho tiếng Việt, tỉ lệ lỗi 4,67% trên bộ VIVOS. Nên thử thêm Whisper large-v3-turbo và EraX-WoW-Turbo trên ghi âm thật của bạn.
Whisper cần card đồ họa bao nhiêu GB?
Chạy bằng faster-whisper, large-v3 cần khoảng 6GB VRAM ở FP16 và khoảng 4GB ở INT8. RTX 3060 hay 4060 là đủ.
Một giờ ghi âm xử lý mất bao lâu?
Trên RTX 4060 khoảng 10–15 phút với large-v3; bản turbo nhanh hơn nhiều.
Có dùng thương mại miễn phí được không?
Whisper (MIT), PhoWhisper (Apache-2.0 trên GitHub, BSD-3-Clause trên Hugging Face) và EraX-WoW-Turbo (MIT) đều cho phép dùng thương mại.